博客
垂直整合的E-house
人工智能基础设施正朝着两个方向同时发展。在芯片层面,超大规模数据中心运营商正加大对定制加速器的投资,这些加速器针对特定工作负载、系统架构和性能目标进行了优化。在数据中心层面,业界正致力于提高机架、电力、冷却、网络和其他基础设施的标准化和互操作性。.
定制芯片正在迅速普及。Counterpoint Research 预计 AI服务器计算ASIC出货量 在谷歌 TPU 基础设施、AWS Trainium 集群以及 Meta MTIA 和微软 Maia 部署量不断增长的推动下,预计 2024 年至 2027 年间,排名前十的参与者规模将增长三倍。TrendForce 也报告称,这一趋势正在增强。 云服务提供商 (CSP) 对 ASIC 的投资 提高工作负载适用性和数据中心成本效益。.
定制芯片并不会完全取代商用GPU。超大规模数据中心运营商在扩展自身芯片项目的同时,仍在GPU平台方面投入巨资,从而构建出一个更加异构的计算环境。TrendForce预计,谷歌和AWS将在2026年下半年加速推出其下一代自主研发的ASIC平台,而市场对NVIDIA机架级系统的需求依然强劲。.
这就带来了一个实际的设计挑战:如何设计出能够满足每个处理器特定散热需求的散热方案,并使其能够融入可大规模部署的标准化基础设施中。.
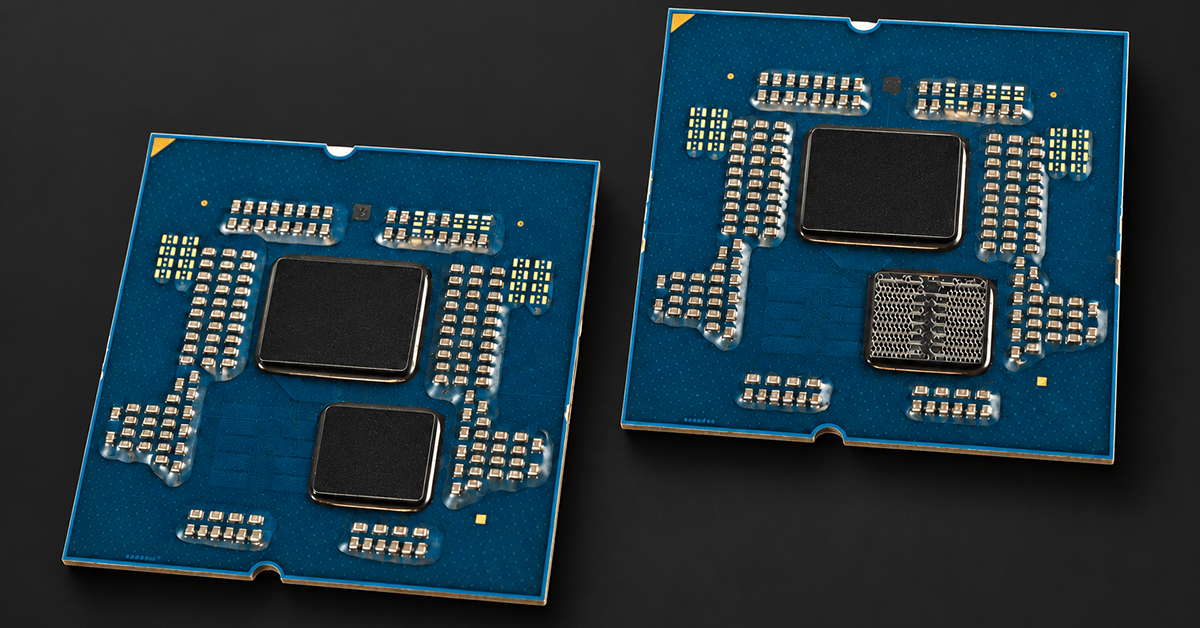
AI加速器的冷却需求并非仅由其功耗决定。一个1500瓦的封装并非仅仅意味着1500瓦的热负荷。工程师必须了解这些热量的来源以及热量如何从硅芯片传递到整个封装,因为两个功耗相同的处理器可能具有截然不同的冷却需求。硅芯片的热特性取决于芯片配置、计算核心的位置和强度、热点、高带宽内存的布局、封装结构、热阻以及允许的工作温度。现代AI加速器可能将多个计算芯片、内存堆栈、中介层和其他组件集成在单个封装内,而不同的组件可能具有不同的热极限。.
麦肯锡指出, GPU和定制硅架构 提前数年确定功率密度、散热和互连要求,将散热纳入计算架构。散热方案的开发可以在量产芯片问世之前就开始。基于未来处理器预期特性建模的热测试载体(TTV)可以模拟其热分布和其他相关的封装特性,使工程师能够在芯片开发仍在进行时对散热解决方案进行实际测试和改进。这使得散热和芯片开发能够并行推进。.
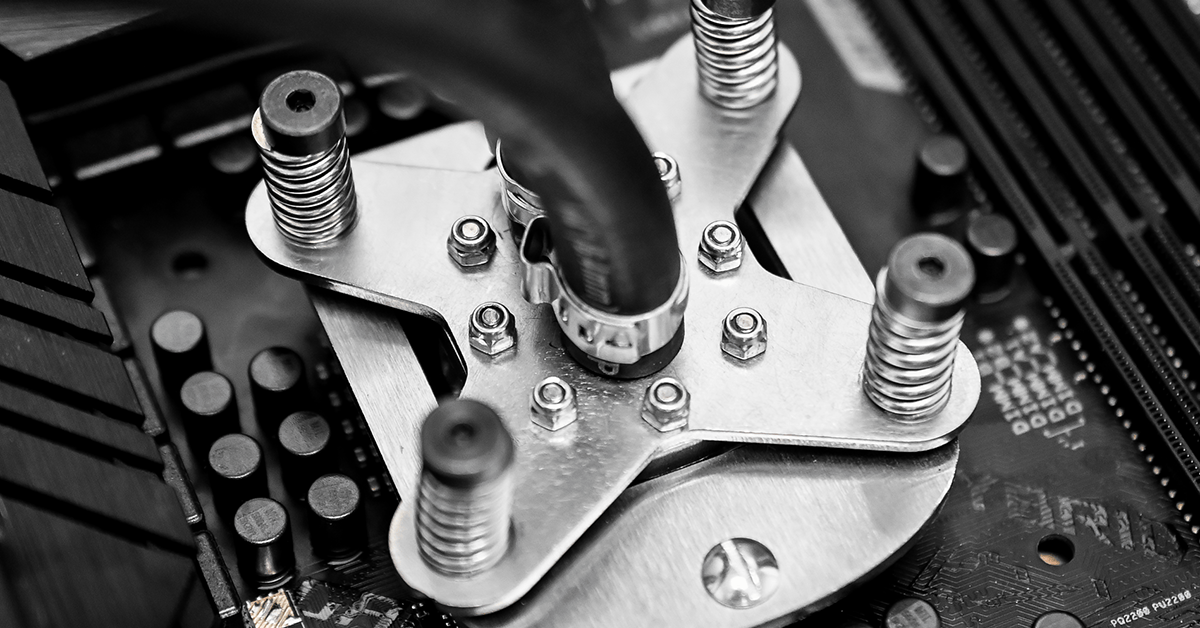
对于许多先进的CPU、GPU、ASIC、网络设备和AI加速器而言, 冷板 这是硅芯片专用冷却技术首次真正成为硬件的地方。它不仅要与封装的热特性相匹配,还必须满足平台的机械、流体和集成方面的限制。.
这意味着设计不仅仅是为了去除更多的热量,而是为了高效地去除热量,保持较低的热阻,控制压降,并使其能够融入一个易于建造、维护和扩展的系统中。.
一旦了解了封装布局和高热流区域,就可以针对处理器调整内部冷板架构,而不是将封装视为均匀的热源。通过优化流路、微对流冲击特性、材料、安装方式和热界面,可以打造出针对最需要冷却的区域或特定类型冷却的解决方案。这对于定制芯片尤为重要,因为芯片布局、存储器位置、封装结构和允许温度等因素在不同的设计中可能存在显著差异。. JetCool 和 Broadcom, 例如,最近发布了一种用于下一代定制AI XPU的芯片级直接冷却解决方案,旨在支持ASIC在高达4 W/mm的热通量水平下持续运行,功耗可达数千瓦。2.
这种专家级的设计工作正是定制化带来价值的所在。冷板的设计充分考虑了处理器的热力学和机械性能要求,同时还兼顾了机架、CDU 和机房水系统的运行条件。这种从芯片到机房的整体冷却设计方法有助于数据中心提高电源和水的利用率,提升存储密度,并在峰值负载下保持性能。.
在超大规模数据中心,每瓦性能、利用率或工作负载经济性的微小提升,都能在庞大的数据中心集群中产生倍增效应。这有助于解释为何要投资于专用芯片。麦肯锡估计,定制芯片可以将其设计用于处理的推理工作负载的单令牌成本降低 70% 到 80%。.
挑战在于,针对特定处理器的优化无法将其余基础设施全部改为一次性设计。在芯片层面,冷却可以根据特定处理器的热分布、封装设计和热极限进行调整。而在远离芯片的层面,流体连接、运行条件、歧管、机架、冷却分配单元 (CDU)、设施水系统和遥测等方面的通用方法,使得不同类型和世代的计算能力能够在生产环境中共存,从而提高密度并简化部署。.
标准化并非消除定制化,而是界定了定制化的适用范围。通过专家设计,与处理器密切相关的工作可以保留在芯片层面,同时机架和设施基础设施保持一致,从而支持大规模的可重复部署。随着定制计算变得越来越普遍,这一界限也变得愈发重要。.
设计一个能正常工作的冷板与制造一个可以大规模复制的热系统之间存在着巨大的差异。内部通道几何形状、平整度、表面光洁度、连接工艺、材料兼容性、清洁度、压力完整性、热界面一致性以及流体分布都会影响冷板的最终性能。在研发阶段,工程师通常可以研究、调整或控制一些细微的偏差。但在生产规模上,同样的偏差必须在数千台服务器乃至数十万个处理器上进行控制。.
这使得 制造能力 这是冷却解决方案的一部分,而不是设计完成后的交接工作。泄漏和压力测试、流量特性分析、热验证、洁净度控制和过程监控都需要随着生产规模的扩大而扩展。它们必须确保每个单元的性能可靠,同时又不减慢生产线速度或使验证环节成为瓶颈。.
对于处理器专用冷却系统而言,原型和量产之间的差距尤为重要。根据特定热图调校的冷板必须在体积增大时仍能稳定地再现预期的流场和冷却效果,同时还要与歧管、机架、冷却分配单元 (CDU) 和设施水系统无缝连接。定制芯片供应商需要一个能够同时满足这两个条件的合作伙伴:既能围绕处理器设计冷却架构,又能以部署所需的工艺控制、可重复性和规模化生产方式进行制造。.
如今,人工智能基础设施依赖于全栈式决策:芯片、封装、供电、散热、机械设计、制造和设施。因此,定制散热方案不能仅仅围绕处理器进行设计。它必须满足芯片的散热需求,与托架、机架、CDU 和设施水系统无缝连接,并为下一代计算做好准备,而无需对周边基础设施进行重新设计。TTV(时间-时间-值)和早期物理测试有助于散热方案的开发与芯片设计同步进行,而制造工程则确保该方案能够在生产规模上重复制造。.
我们的人工智能基础设施能力涵盖 处理器专用冷板和芯片级液冷 通过歧管、CDU、IT机架、嵌入式和关键电源以及集成数据中心基础设施。结合系统工程和 大规模先进制造, 这种广度创造了一条从针对特定处理器热图调整的冷却解决方案到可重复的机架和设施级基础设施以及大批量部署的路径。.